
Customer Case 02
Fabric 기반 데이터 플랫폼
프로젝트 개요
Jira와 SharePoint를 기반으로 데이터를 활용해 온 제조 기업입니다. Jira를 On-premise에서 Jira Cloud로 이관하게 되면서 데이터를 수집하는 영역이 바뀌었습니다.
폴라리스클라우드는 이 변화에 맞춰 Jira·SharePoint 중심의 데이터 사용 구조를 Microsoft Fabric 중심의 통합 데이터 활용 구조로 전환했습니다.
| 업종 | 제조 |
|---|---|
| 수행 기간 | 2026.04.20 ~ 2026.07.03 |
| 적용 기술 | Microsoft Fabric(Lakehouse, Notebook, Data Pipeline), Power BI |
도입 배경
기존 Jira 데이터 활용 환경에서는 데이터 수집과 보고서 운영에 어려움이 있었습니다.
- 데이터 수집 및 갱신: Jira 데이터를 SharePoint 파일과 보고서별 쿼리로 수집했으며 보고서는 자동화 없이 개별 갱신했습니다.
- 보고서 배포: Power BI 보고서를 로컬 PBIX 파일과 기존 작업영역에서 관리해 원천 변경의 영향이 보고서에 직접 전달되는 구조였습니다.
Jira Cloud 이관으로 데이터 수집 환경까지 바뀌면서 원천 데이터와 보고서를 분리할 수 있는 통합 데이터 구조가 필요해졌습니다.
주요 구축 내용
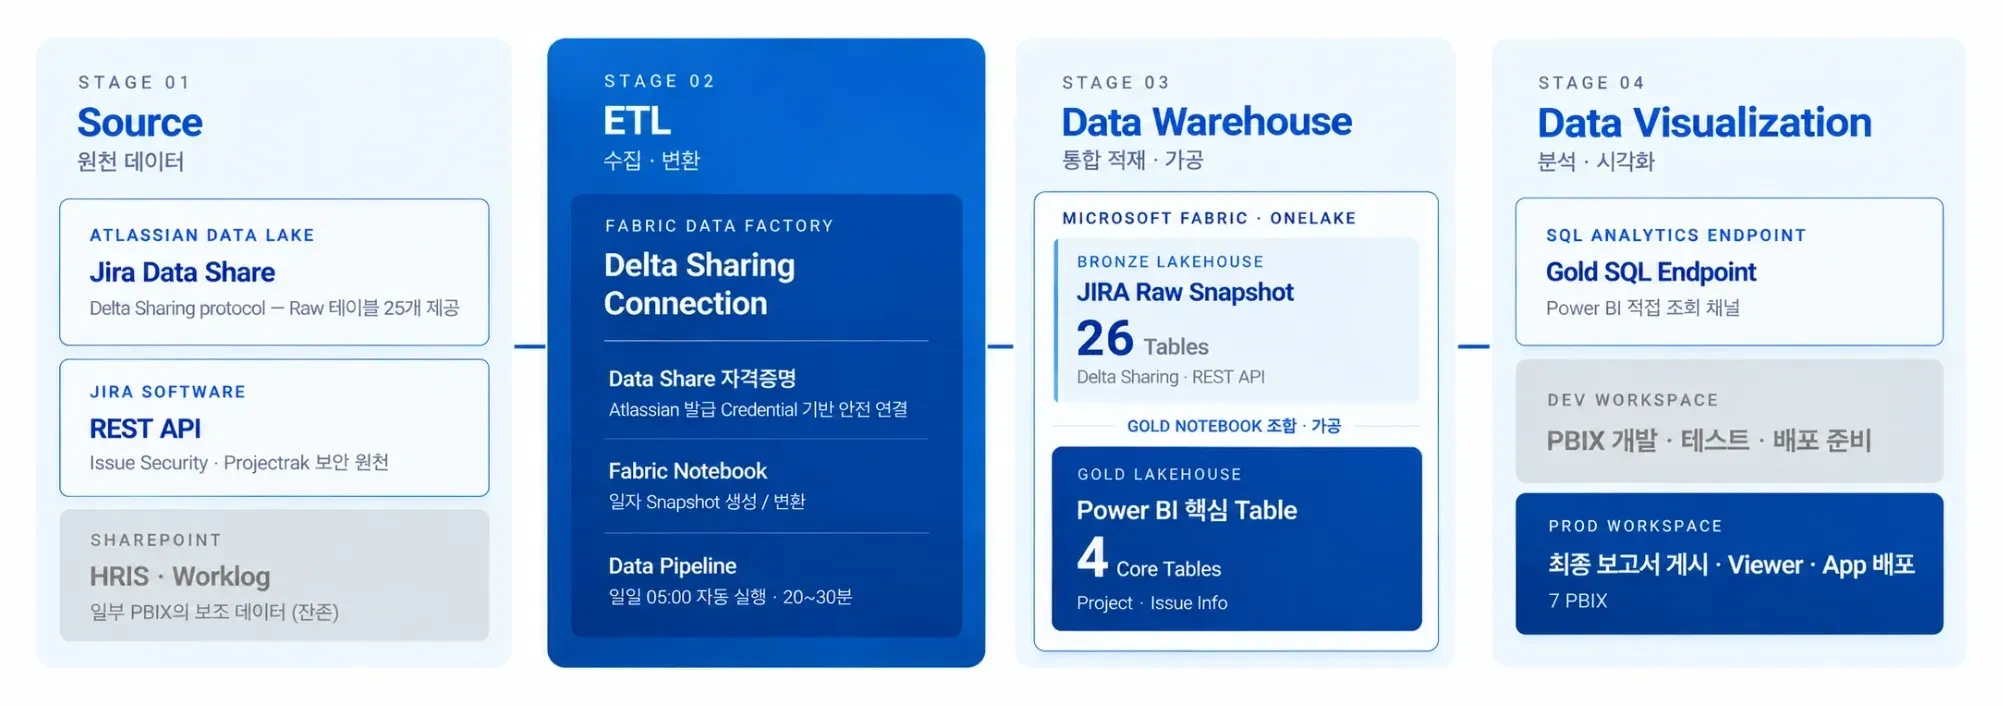
Jira 데이터를 Fabric에 적재해 가공하고, 그 결과를 Power BI에 연결하는 순서로 구축했습니다.
- Jira 데이터 연계: Atlassian Data Lake의 Jira Data Share를 Delta Sharing 방식으로 Fabric에 연결했습니다. 접속에는 Atlassian이 발급한 자격증명을 사용합니다. 보완이 필요한 데이터는 Jira REST API와 Projectrak API로 가져옵니다. 일부 보고서의 보조 데이터(HRIS·Worklog)는 아직 SharePoint에서 읽어 옵니다.
- Lakehouse 구성: Bronze Lakehouse에는 Jira 데이터를 일별 Snapshot으로 적재합니다. 이 데이터를 조합·가공해 Power BI용 핵심 테이블(프로젝트·이슈 정보)을 Gold Lakehouse에 구성했습니다.
- 작업 자동화: Fabric Notebook이 일자별 Snapshot을 만들고 변환합니다. Data Pipeline은 이 작업을 매일 05:00에 자동으로 실행하며, 1회 실행에는 평균 약 20~30분이 걸립니다.
- Power BI 연계: Power BI의 원천을 Gold SQL Endpoint로 바꿔 Gold 테이블을 직접 조회하게 했습니다. 기존 PBIX 7종은 개발·운영 작업영역으로 나누어 다시 게시했습니다.
구축 결과 및 변화
이번 구축으로 원천 데이터 수집과 보고서 운영이 분리되었습니다. Bronze Lakehouse 테이블 26개와 Gold Lakehouse 핵심 테이블 4개를 구성했고, Power BI 원천 변경과 별도 작업영역 게시(PBIX 7종)를 마쳤습니다. 구축 전후 비교는 아래 표에 정리했습니다.
| 구분 | Before | After |
|---|---|---|
| 원천 수집 | SharePoint 파일과 개별 보고서 중심으로 수집 | Jira Data Share 기반으로 Fabric에 중앙 적재 |
| 데이터 구조 | 보고서별 파일·쿼리에 의존 | Bronze·Gold 계층 구조로 정리 |
| 갱신 방식 | 자동화 없이 각 리포트를 개별 갱신 | Notebook·Pipeline 기반 매일 자동 적재 |
| 보고서 배포 | 로컬 PBIX와 기존 작업영역에서 배포 | 별도 Power BI 작업영역을 구성해 재게시 |
| 원천과 보고서 | 원천 변경이 보고서에 직접 전달 | Fabric 데이터 계층을 통해 원천과 보고서 분리 |